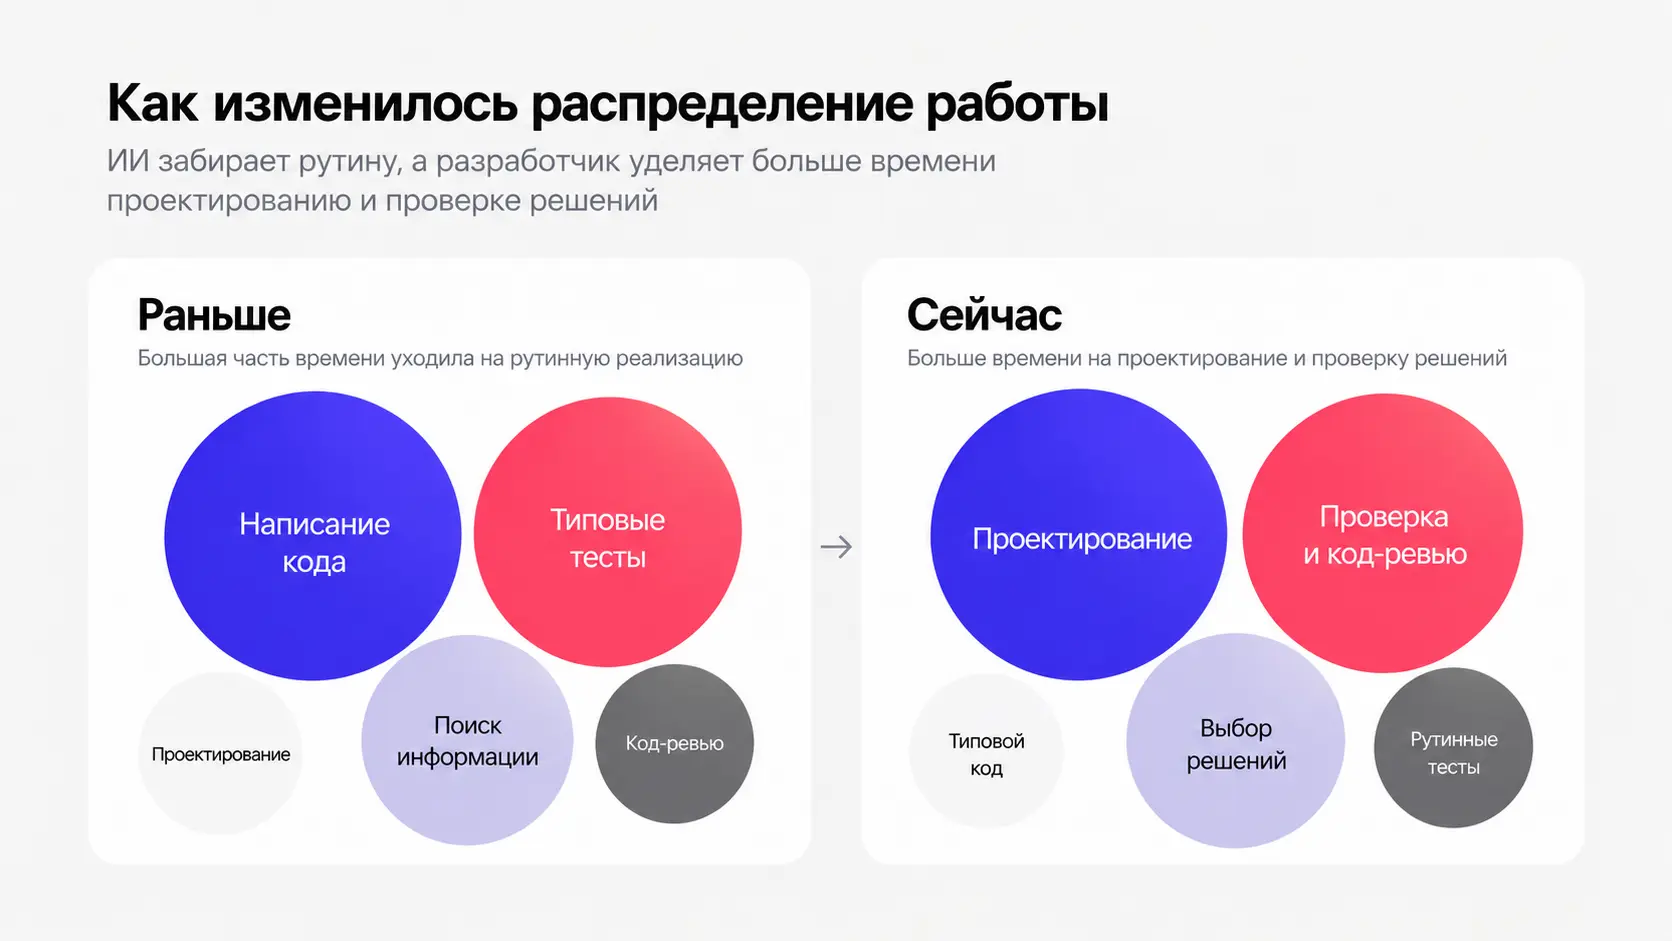
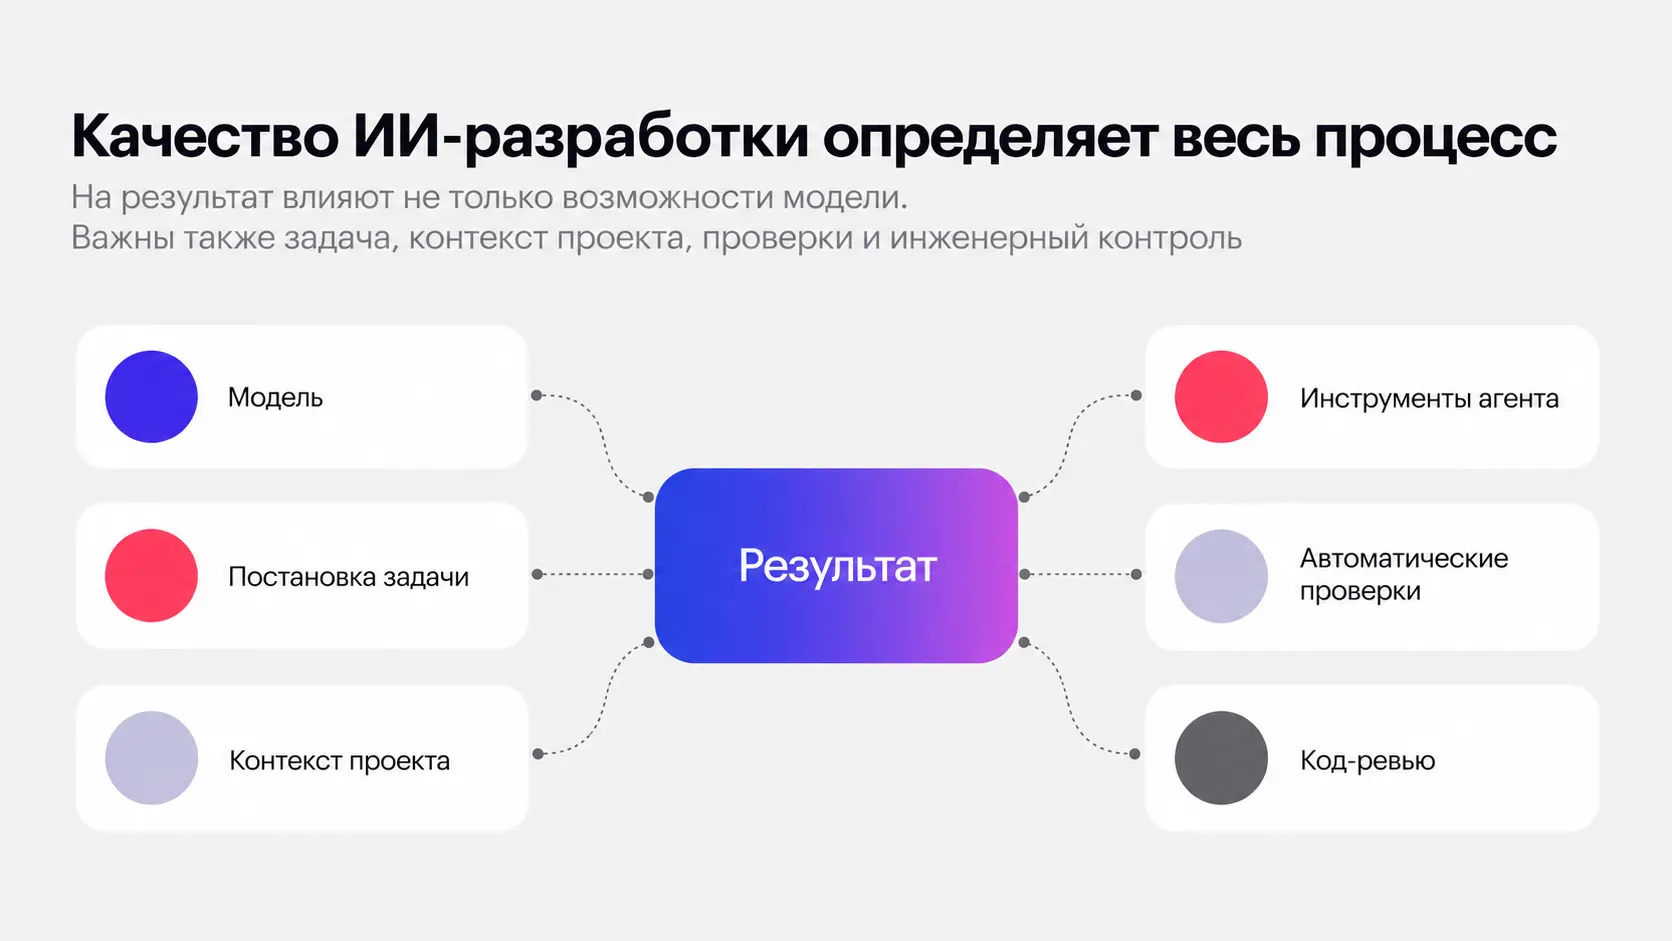
ИИ уже пишет функции и тесты, исправляет ошибки и работает с целыми репозиториями. Но результат зависит не только от модели: на него влияют постановка задачи, контекст проекта, автоматические проверки и инженерное ревью.
От чего зависит качество разработки с ИИ
Одной и той же модели можно дать короткое описание функции и принять первый ответ. А можно определить требования, предоставить правила проекта, разрешить запуск тестов и статического анализа, а затем проверить изменения вручную.
В обоих случаях код создаёт ИИ. Но процессы разработки различаются, а вместе с ними различаются количество ошибок, трудозатраты на проверку и стоимость дальнейших изменений.
Исследования ИИ-разработки хорошо показывают эту зависимость. Их результаты нельзя свести к вопросу «пишет ли нейросеть лучше человека». Гораздо полезнее смотреть, для каких задач, в каких условиях и при каком контроле она сокращает работу команды.
Генерация кода не равна ускорению разработки
В 2025 году исследовательская организация METR провела эксперимент с 16 разработчиками открытого ПО. Участники выполнили 246 задач в проектах, с которыми до этого работали в среднем около пяти лет. Для каждой задачи случайно определяли, разрешено использовать ИИ или нет.
До эксперимента разработчики предполагали, что ИИ сократит время работы примерно на 24%. После выполнения задач они оценили ускорение примерно в 20%.
Измерения показали другой результат: задачи с доступом к ИИ занимали в среднем на 19% больше времени.
Эту цифру нельзя переносить на всю разработку. Участники хорошо знали свои кодовые базы, а эксперимент использовал инструменты первой половины 2025 года. В 2026 году METR начала новые эксперименты, но исследователи не стали публиковать точную оценку ускорения из-за смещения выборки.
Обновление METR о новых экспериментах 2026 года
Для практики важен другой вывод: ощущение высокой скорости не гарантирует сокращения общего времени работы.
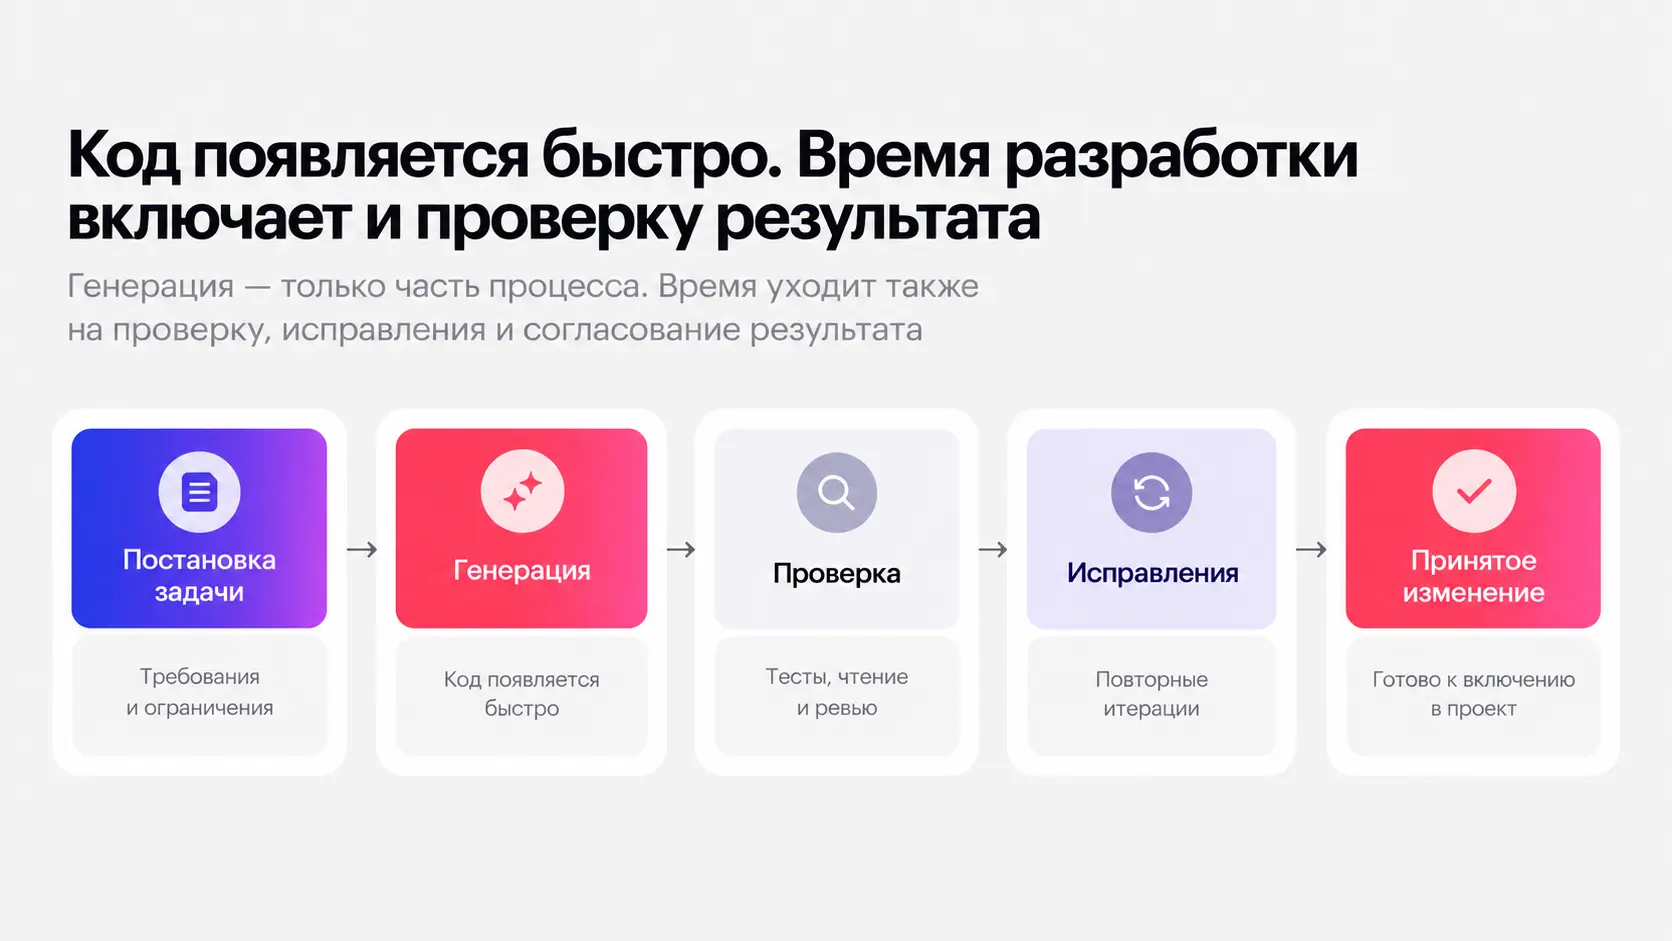
ИИ выдаёт код за секунды или минуты. После этого разработчику нужно прочитать изменения, найти неверные предположения, проверить интеграцию с остальным проектом, исправить ошибки и запустить проверки.
Поэтому полезнее измерять не количество сгенерированного кода, а время до реализации, которую команда готова принять и сопровождать.
Сгенерированный код тоже создаёт технический долг
В исследовании Debt Behind the AI Boom авторы проанализировали около 302,6 тысячи идентифицированных ИИ-коммитов из 6299 публичных GitHub-репозиториев. В выборку вошли изменения, связанные с GitHub Copilot, Claude, Cursor, Gemini и Devin.
До и после каждого коммита исследователи запускали статический анализ. Более 15% коммитов каждого из пяти инструментов добавляли как минимум одну обнаруживаемую проблему. Около 22,7% отслеживаемых проблем сохранялись в последней исследованной версии репозитория.
Debt Behind the AI Boom: A Large-Scale Empirical Study of AI-Generated Code in the Wild
У исследования есть ограничения. Это препринт, авторство ИИ определялось по доступным метаданным Git, а анализ охватывал Python, JavaScript и TypeScript. Статический анализ также не способен оценить соответствие бизнес-требованиям или архитектуре системы.
Но работа показывает практический риск. Дублирование логики, лишняя зависимость или нарушение правил проекта могут почти не повлиять на время создания функции. Затраты появятся позже — при изменении, поиске ошибки или обновлении системы.
Похожий вывод содержит отчёт State of Software 2026 компании Software Improvement Group. По данным SIG, ИИ-код в их выборке получил больше замечаний по безопасности и сопровождаемости, а разрыв по сопровождаемости рос вместе с размером кодовой базы.
State of Software 2026 — Software Improvement Group
Этот источник тоже требует оговорки: SIG выпускает коммерческие инструменты и услуги для анализа качества ПО. Поэтому её данные стоит воспринимать как отраслевое наблюдение на собственной выборке, а не как универсальную оценку всего ИИ-кода.
Для разработки здесь важен масштаб системы.
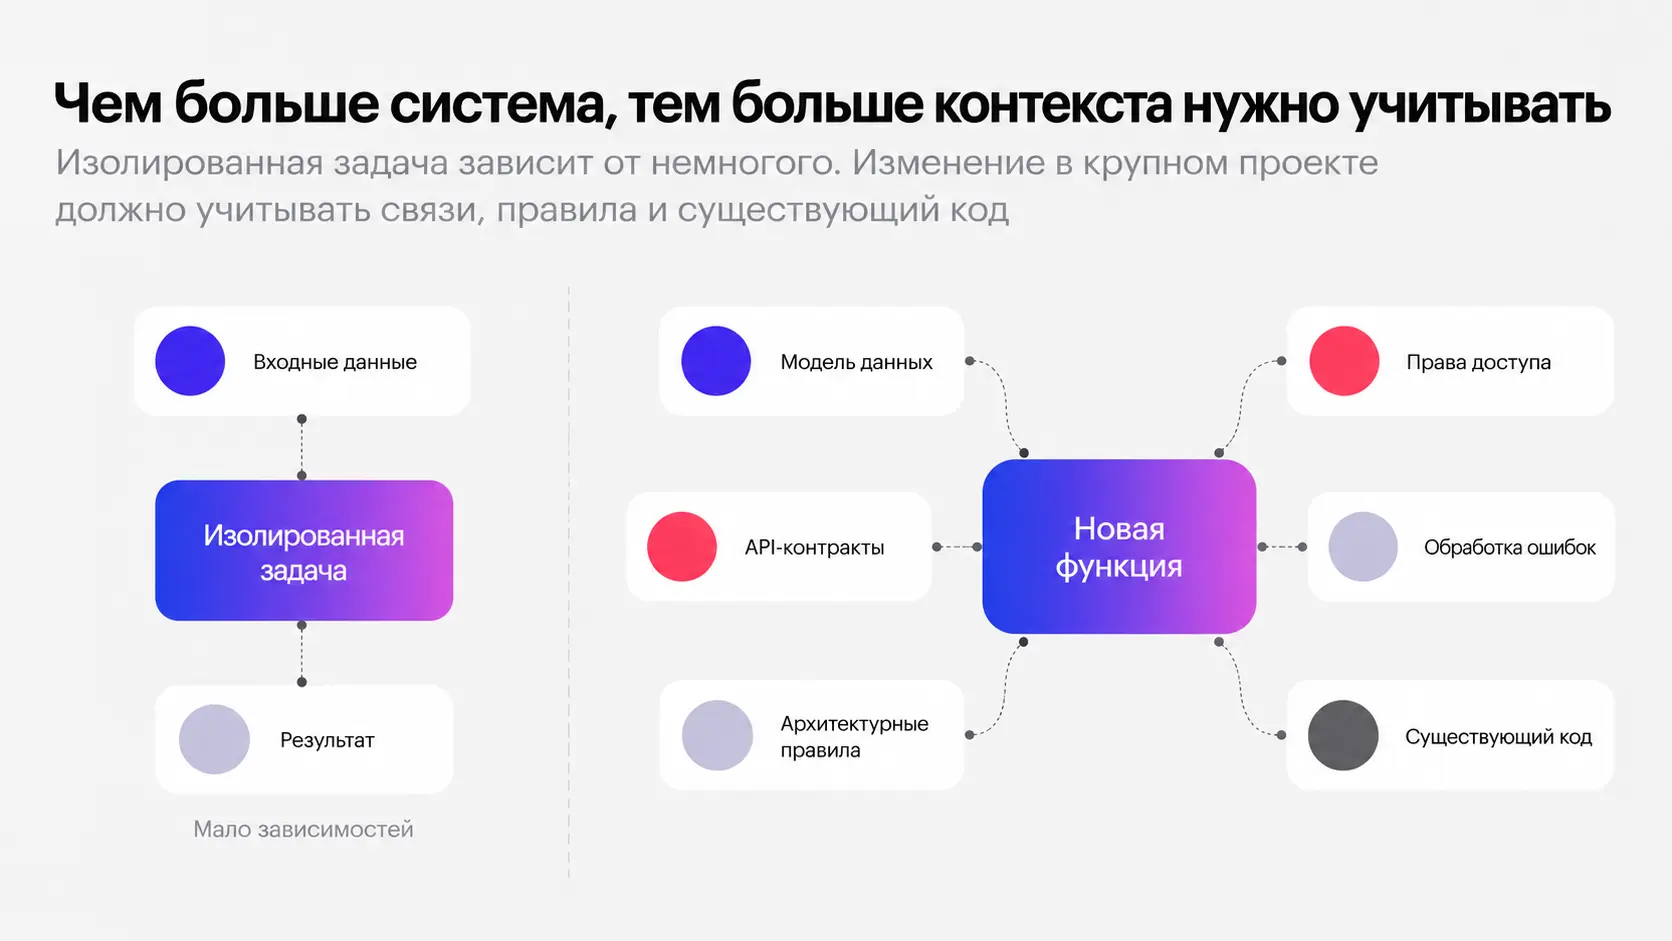
Изолированная функция зависит от небольшого числа условий. Изменение в крупном проекте должно учитывать модель данных, права доступа, контракты компонентов, обработку ошибок и решения, которые команда приняла раньше.
Поэтому система не превращается в поддерживаемый продукт простым сложением отдельных работающих функций.
Стоимость ИИ-разработки складывается не только из цены модели
Coding agent обычно выполняет несколько действий подряд: изучает проект, планирует изменения, редактирует файлы, запускает тесты, анализирует ошибки и повторяет попытку.
Некоторые процессы используют несколько агентов: один исследует код, другой пишет реализацию, третий проверяет результат. Каждый этап расходует токены и вычислительные ресурсы.
Gartner прогнозирует, что к 2028 году расходы на агентную разработку могут превысить среднюю зарплату разработчика. Среди причин компания называет рост потребления токенов, длинный контекст и автономные циклы без ограничений.
Gartner: AI Coding Costs Will Surpass Average Developer’s Salary by 2028 as Token Consumption Surges
Это прогноз, а не измерение будущих расходов. Цена моделей снижается, появляются новые поставщики и open-weight решения.
Но снижение цены одного запроса не гарантирует снижения стоимости процесса. Если вместо одного обращения агент выполняет двадцать итераций, использует несколько моделей и каждый раз получает большой контекст, общий расход может расти.
Поэтому управление ИИ-инструментами постепенно становится частью инженерного процесса. Для простой задачи не всегда нужна модель с максимальной стоимостью вызова. Агенту не стоит передавать весь репозиторий, если задача касается нескольких файлов. Цикл исправлений тоже требует ограничений.
Экономия появляется тогда, когда команда сопоставляет стоимость вычислений с ценностью результата.
Почему исследования дают разные результаты
Одни эксперименты фиксируют ускорение, другие — отсутствие выигрыша или рост времени выполнения задач. Это не обязательно противоречие.
Под словом «разработка» скрываются разные виды работы.
Написать изолированную функцию в новом проекте и изменить компонент системы, которую поддерживают несколько лет, — разные задачи. Отличаются также опыт разработчика, размер доступного контекста, используемая модель, инструменты агента и критерии проверки результата.
Даже прохождение автоматических тестов не всегда означает готовность изменения к включению в проект. METR в отдельной работе сравнивала автоматическую оценку с ручным ревью и показала, что тесты могут оценивать результат выше, чем разработчики при проверке кода.
Поэтому универсальная цифра «ИИ ускоряет разработку на X процентов» мало говорит о конкретном проекте. Для команды важнее собственные метрики: сколько времени занимает задача целиком, сколько изменений возвращается на доработку и сколько проблем обнаруживается после интеграции.
Качество ИИ-разработки определяет весь процесс
ИИ сокращает время на создание реализации. Но генерация кода — только один этап разработки.
Чтобы получить результат, пригодный для дальнейшей работы, агенту нужны требования, информация о проекте и критерии проверки. Тесты, статический анализ и линтеры помогают обнаруживать часть ошибок. Архитектурные правила ограничивают решения, которые подходят локально, но нарушают устройство системы. Разработчик проверяет то, что автоматические инструменты оценить не могут.
Поэтому мы не измеряем пользу ИИ количеством написанных строк или временем до первой работающей версии.
Нас интересует время до изменения, которое соответствует требованиям, проходит проверки, вписывается в архитектуру проекта и не усложняет следующие задачи.
ИИ снизил стоимость генерации кода. Проектирование, проверка и сопровождение по-прежнему требуют инженерной работы.