Представим обычный созвон по новому сайту. Подрядчик предлагает агентную разработку, маркетолог просит заложить GEO, руководитель интересуется, можно ли всё развернуть на своей модели. Кто-то произносит «харнес». Остальные решают пока не уточнять.
Знакомая ситуация для диджитала: технология ещё меняется, а профессиональный язык вокруг неё уже успел усложниться. Причём за соседними словами могут скрываться и принципиально разные вещи, и почти одинаковые услуги.
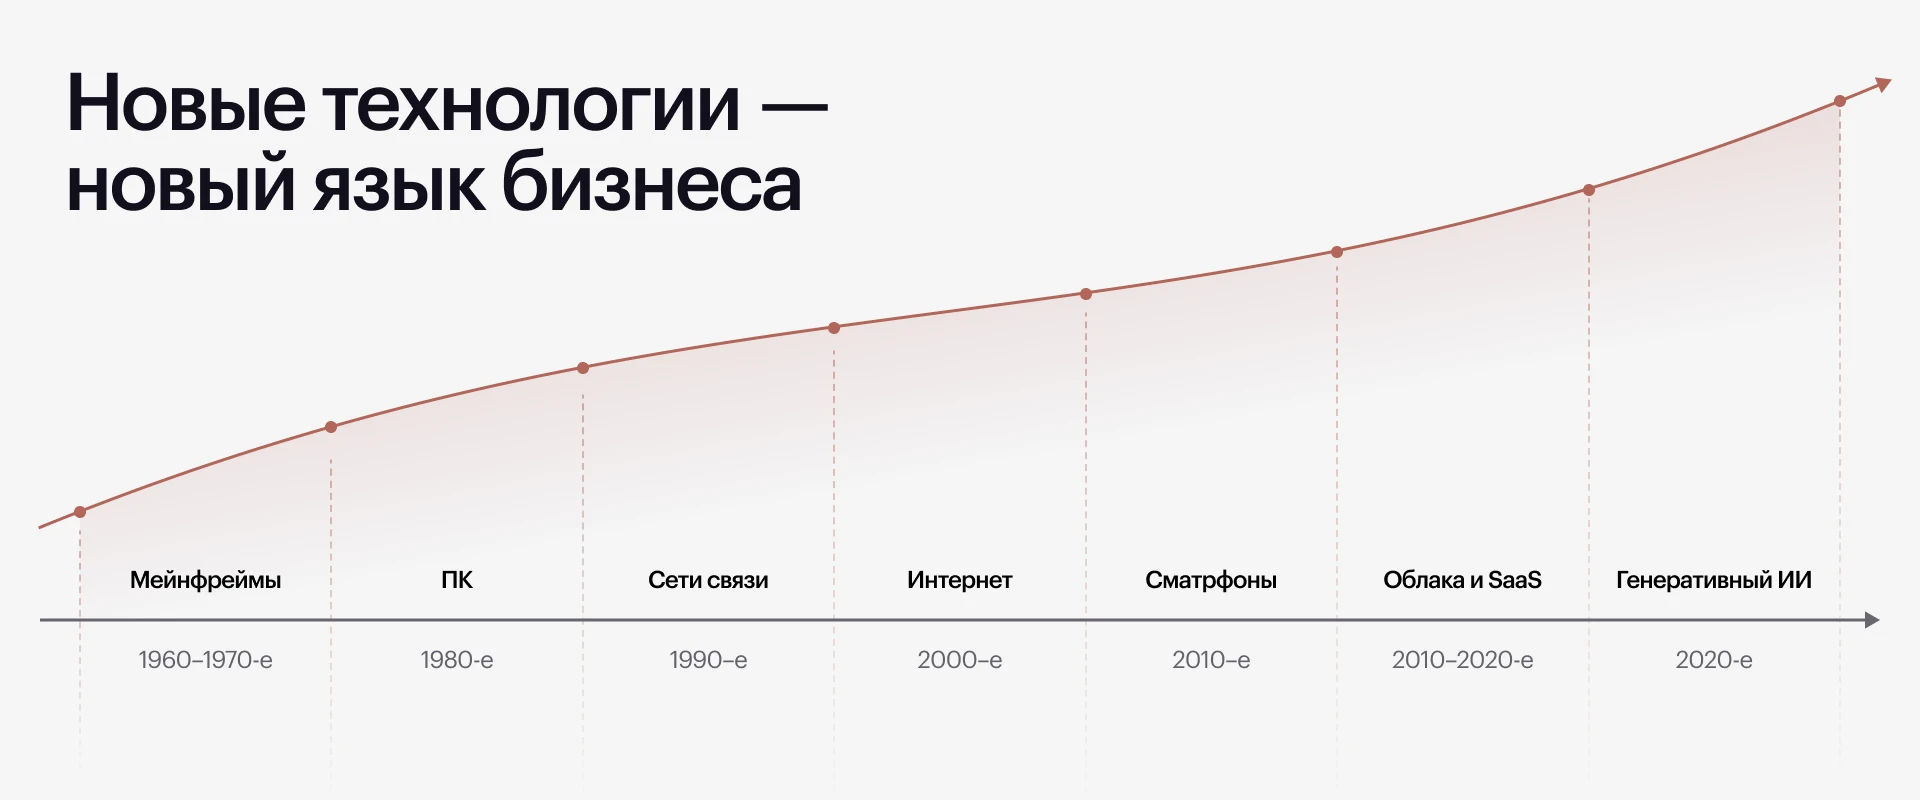
Мы в Мэйк собрали понятия, которые помогают разобраться, что именно предлагают сделать с помощью ИИ. Некоторые полезно знать при обсуждении проекта. Другие — когда смотришь на результат и пытаешься понять, почему он вроде бы правильный, но публиковать его совершенно не хочется.
Небольшая оговорка: это практические объяснения, а не строгий стандарт терминологии. Участники рынка используют некоторые слова по-разному.
Промпт — инструкция, которую мы даём ИИ. Написанная текстом или наговорённая голосом.
«Сделай страницу для нашего магазина мебели» — промпт. «Сделай страницу доставки, используй эти тарифы, отдельно объясни подъём без лифта, не обещай доставку за пределами области» — тоже промпт, но с гораздо меньшим пространством для фантазии.
У маркетологов здесь есть преимущество: они уже знакомы с брифами. Понимание аудитории, факты о продукте, ограничения и примеры нужны ИИ по той же причине, по которой они нужны агентству.
При этом промпт — только часть информации, доступной модели. Есть ещё переписка, приложенные документы, найденные страницы и результаты предыдущих действий. Вместе они образуют контекст.
Контекстное окно ограничивает объём информации, с которым модель может работать за один раз. Удобно представить рабочий стол: на него помещается много документов, но весь архив компании постоянно лежать перед глазами не может. Подробнее о работе с контекстом — у Anthropic. В нашей внутренней рекомендации по работе с ИИ, как только чат превысил 30-50 сообщений (ваших) просите ИИ сделать конспект этого чата и с ним перейдите в новый чат.
Объём контекста и генерируемого текста часто измеряют токенами — небольшими единицами, на которые разбивается информация. В тексте токен может соответствовать слову, части слова или символу.
Для небольших задач обычно хватает с лихвой токенов что заложены в подписку, а вот для сложной разработки или автоматизации их приходится покупать отдельно или разворачивать модель на своем сервере.
Теперь разберём главную путаницу: модель и агент.
Модель — обученная система, которая обрабатывает входные данные и формирует ответ. Она может анализировать текст, писать код, работать с изображениями — возможности зависят от конкретной модели.
Из известных семейств на рынке встречаются GPT от OpenAI, Claude от Anthropic и Gemini от Google. Среди семейств, в которых есть модели с доступными для самостоятельного запуска весами, — Qwen, DeepSeek, Mistral и Gemma.
Есть и специализированные модели, поизучать их можно на платформе Hugging Face.
ИИ-агент — система, которая использует модель, чтобы выполнять задачу в несколько шагов и выбирать следующие действия.
Допустим, нужно выяснить, почему за неделю снизились продажи магазина. Агент может получить данные из аналитики, проверить рекламные расходы, заметить изменение конверсии, запросить статистику по устройствам и подготовить объяснение. Маршрут исследования частично определяется по ходу работы.
Чтобы всё это происходило, одной модели недостаточно.
Нужны инструменты, или tools: поиск, чтение файлов, запрос к аналитике, работа с таблицами, изменение кода. Для модели инструмент — доступное действие с определёнными параметрами. Возможность прочитать рекламный отчёт и возможность изменить бюджет кампании должны быть разными разрешениями.
Нужна и программа, которая организует работу: отправит запрос модели, выполнит выбранный инструмент, вернёт результат, сохранит состояние и решит, когда остановить процесс.
Эту программную обвязку называют харнесом — harness.
В зависимости от реализации харнес также управляет контекстом, ограничениями, повторными попытками после ошибок и запросами на подтверждение действий. Именно как окружающую модель систему исполнения харнес описывает OpenAI в документации своей агентной платформы.
Получается примерно такая конструкция: модель + инструменты + харнес + рабочие данные и среда = агентная система.
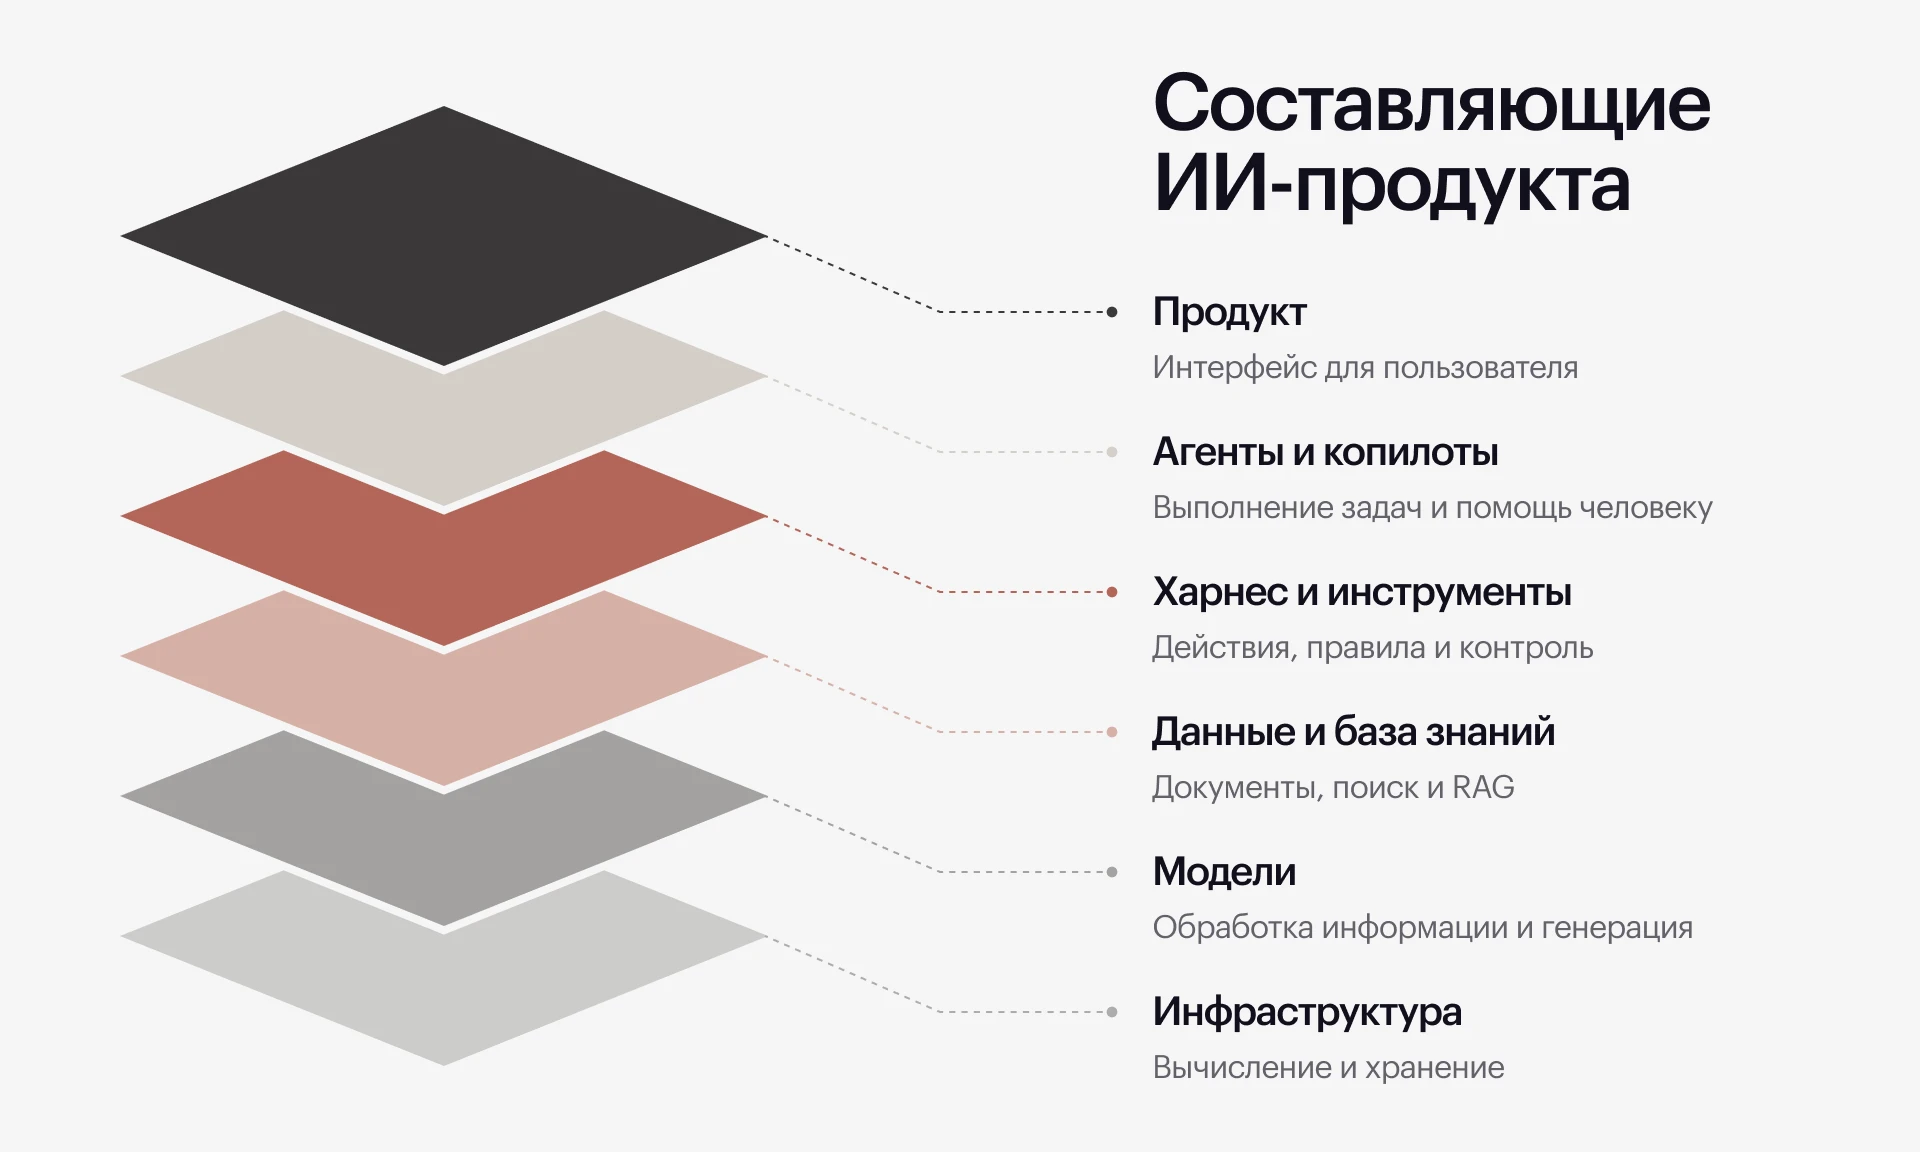
Сегодня инструменты с ИИ-агентами для разработки можно разделить на три группы.
Готовые среды разработки: Claude Code, Codex и агент в Cursor позволяют поручать задачи по коду и проверять внесённые изменения в едином рабочем пространстве.
Открытые агентные инструменты: OpenCode и Qwen Code дают готовую основу, которую можно настраивать и дорабатывать под собственные задачи.
Платформы для создания своих процессов и агентов: n8n и LangGraph предоставляют компоненты для подключения данных и действий, а также настройки логики и правил работы агентов.
Копилот, автоматизация и оркестрация описывают то, как организована работа.
Копилотом обычно называют помощника, рядом с которым человек продолжает вести задачу: выбирает предложения, уточняет, переносит результат дальше. Например, маркетолог анализирует кампанию и просит объяснить аномалию в отчёте.
ИИ-автоматизация — процесс, в котором часть операций выполняется с помощью ИИ. Пришло обращение → модель определила тему → система назначила ответственного. Маршрут здесь может быть задан заранее, и самостоятельный агент для него не обязателен.
Оркестрация — координация всей работы: что выполняется первым, что можно делать одновременно, куда передать результат, как обработать ошибку и когда подключить человека.
Предположим, система готовит еженедельный маркетинговый отчёт. Сначала получает данные из рекламных кабинетов и CRM. Потом сверяет периоды, считает показатели, формирует комментарий. Если выгрузка не пришла, сообщает об этом вместо того, чтобы изображать полноценный отчёт.
Оркестрация описывает именно эти связи и правила. Она может управлять одним агентом, несколькими агентами или смесью обычных программ и ИИ.
Вайбкодинг начинается там, где человек собирает программу через разговор и оценивает прежде всего получившееся поведение.
Маркетолог просит сделать калькулятор стоимости кухни. Получает страницу, вводит несколько значений, меняет цвета, добавляет поля. Код существует где-то внутри, но подробно разбираться в нём никто не планирует.
Это полезный способ проверить идею, собрать демонстрацию или личный инструмент. Можно быстро увидеть, нужен ли вообще задуманный сценарий, прежде чем подробно проектировать систему.
Однако работающий “экран” отвечает только на часть вопросов. Нужно ещё выяснить, правильно ли считаются нестандартные случаи, где сохраняются данные и что произойдёт при следующем изменении.
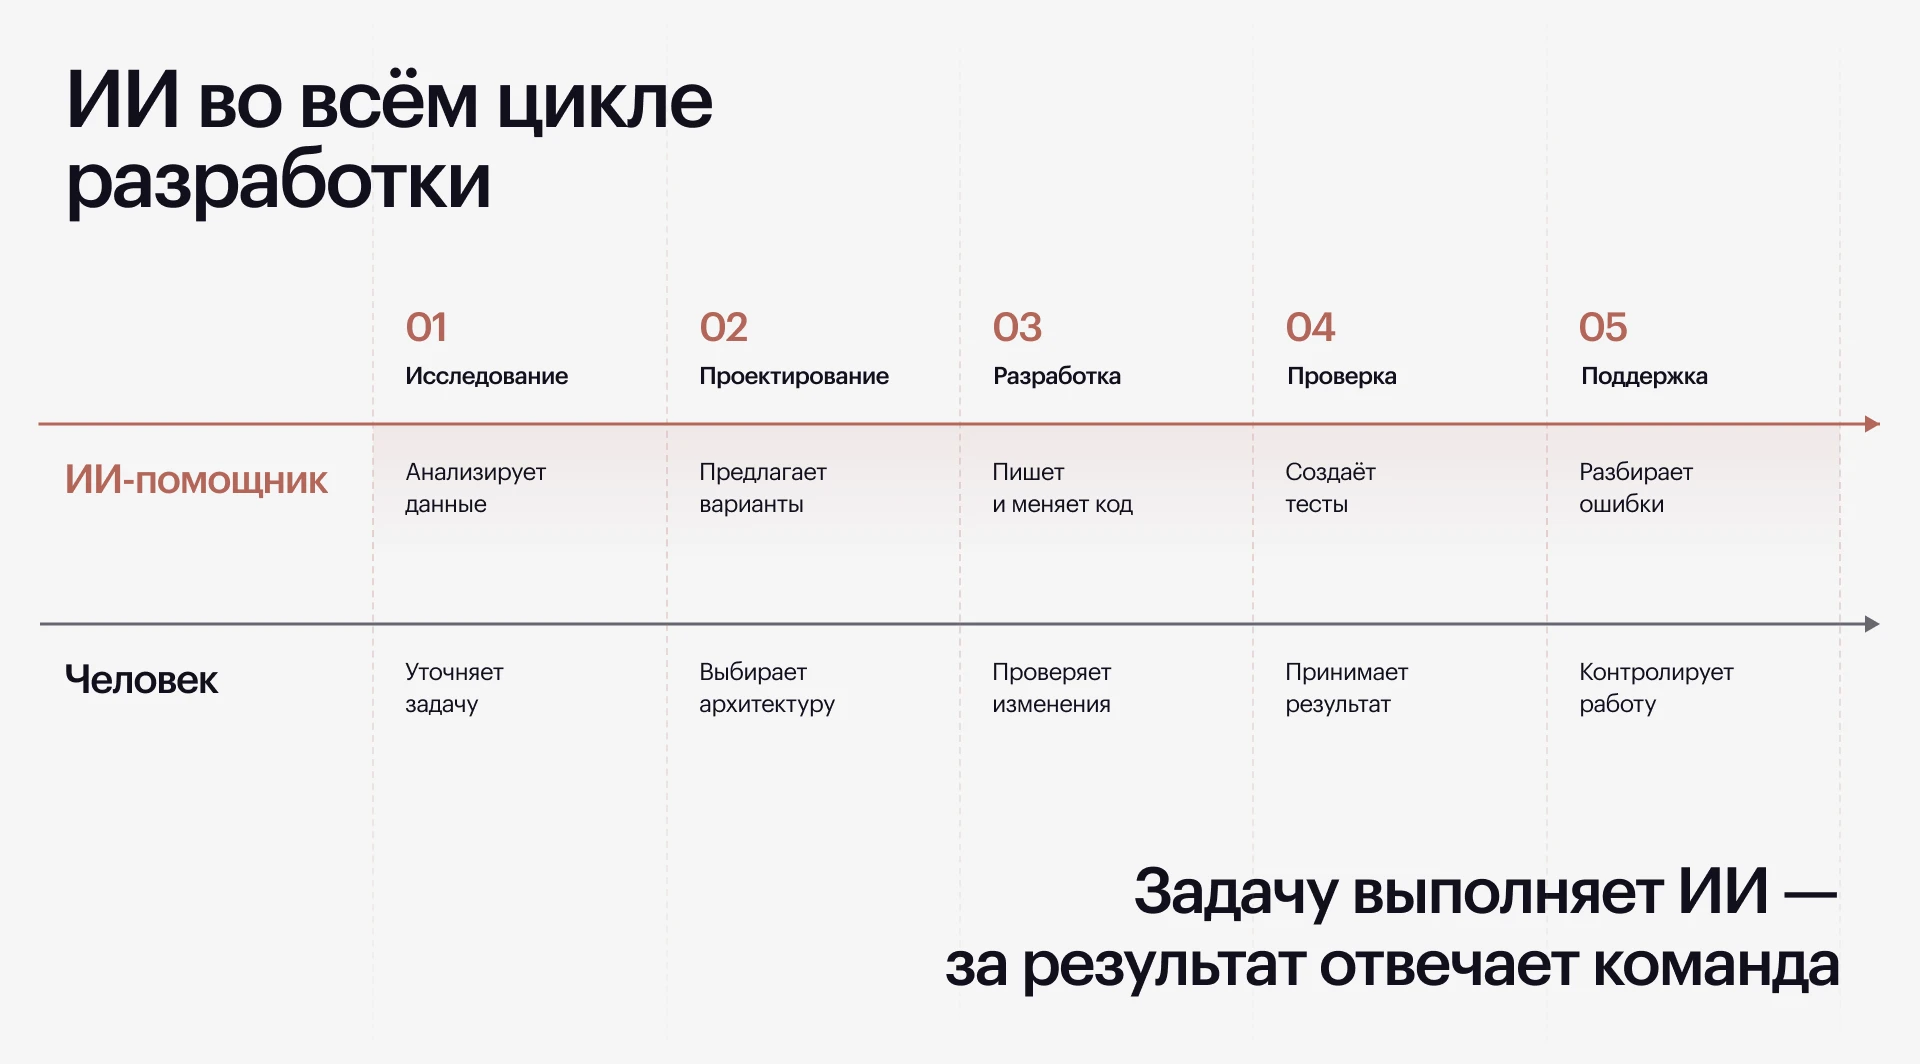
При агентной разработке под контролем инженера код тоже может почти целиком писать ИИ. Инженер при этом определяет требования, оценивает устройство решения, проверяет изменения и организует выпуск.
Такая система считает управляемой и подходящей для внедрения в бизнес, в отличии от вайбкодинга инженеры анализируют и декомпозируют задачи, здесь ИИ пишет конкретные проверяемые блоки кода. Пример из бизнеса когда талантливому новичку маркетологу дают крупную задачу (например обеспечить маркетинг выхода нового продукта на рынок) он безусловно что-то сделать, но вероятность хорошего результата как в казино.
RAG появляется в разговоре, когда ИИ нужно работать с информацией компании.
База знаний — это сами материалы: инструкции, условия доставки, описание товаров, правила обслуживания.
RAG — Retrieval-Augmented Generation — подход, при котором система сначала находит подходящие сведения, а затем передаёт их модели для подготовки ответа. Покупатель спрашивает про подъём дивана на пятый этаж — система ищет соответствующий пункт в условиях доставки и использует его в ответе. Так устройство RAG объясняет Google Cloud.
В предложениях это иногда называют «обучением нейросети на документах компании». Стоит уточнить, что именно собираются делать: подключение поиска по документам само по себе не означает дообучение модели.
Здесь мы подходим к галлюцинациям — убедительно сформулированным, но неверным или выдуманным сведениям в ответе модели.
Для маркетолога это может быть несуществующее исследование, для интернет-магазина — придуманная характеристика товара. Ошибка особенно неприятна тем, что внешне предложение часто выглядит совершенно нормальным.
RAG помогает опираться на источники, но не исключает ошибок. Система может найти не тот документ, использовать устаревшую версию или неверно истолковать формулировку. Поэтому полезно проверять одновременно и ответ, и материал, на котором он основан.
GEO и AEO относятся уже к тому, как аудитория находит компанию.
AEO — Answer Engine Optimization — оптимизация присутствия в системах, которые дают готовые ответы. В широком употреблении сюда относят и некоторые форматы поиска, появившиеся до нынешней волны генеративного ИИ.
GEO — Generative Engine Optimization — работа над видимостью в ответах генеративных систем: чтобы они корректно упоминали компанию, использовали её материалы и ссылались на подходящие страницы.
На практике термины пересекаются. Универсальной границы между ними нет; разницу в употреблении признают и участники рынка, например HubSpot.
Представим, что человек спрашивает у ИИ, где заказать кухню сложной формы. Для производителя имеет значение, попадёт ли он в ответ, какие сведения о нём будут приведены и получит ли пользователь ссылку на полезную страницу.
Но одного названия новой услуги недостаточно, чтобы понять методику. Нужно выяснить, какие системы и запросы проверяют, какие изменения вносят и как измеряют результат.
Google, например, прямо пишет: для появления в AI Overviews и AI Mode сохраняются основные требования SEO; отдельная специальная оптимизация и особая разметка не нужны. Это утверждение относится к ИИ-функциям поиска Google, а не ко всем существующим сервисам. Источник — Google Search Central.
Наконец, собственная модель на сервере. Здесь разговор о терминах встречается с бюджетом.
В таких проектах обычно берут готовую модель с доступными весами и запускают её на своей инфраструктуре или арендованном оборудовании.
Доработка харнеса при этом не обязательно затрагивает саму модель. Можно изменить правила выбора данных, добавить инструменты, настроить проверки и остановки. Например, научить систему получать характеристики из каталога, проверять обязательные поля и отправлять спорные карточки редактору.
Такой проект имеет смысл рассматривать, когда есть большой повторяющийся поток задач, понятные требования к качеству, необходимость контролировать размещение данных и команда, способная поддерживать систему.
Именно с такими задачами мы помогаем бизнесу, если у вас есть такие задачи напиши нам.
Полную стоимость составляют оборудование или аренда, запуск и доработка, поддержка, проверки и ручные исправления. Требования к оборудованию зависят от размера модели, объёма контекста и числа одновременных задач. «Развернуть у себя» может означать как одну машину, так и существенно более серьёзную инфраструктуру.
Условный пример, исключительно для понимания расчёта. Допустим, дополнительные постоянные расходы на собственное решение составляют 120 тысяч рублей в месяц. Обработка одной задачи во внешнем сервисе стоит 4 рубля, переменные расходы на своём решении — 1 рубль. При сопоставимом качестве разница покрывает постоянные расходы примерно на 40 тысячах задач в месяц.
Это не рыночные тарифы. Если свой вариант потребует больше ручной проверки, повторных запусков или резервных мощностей, расчёт изменится. Сравнивать нужно стоимость принятого результата.
Для небольшого потока разнородных задач внешний сервис может быть экономичнее. Для стабильной массовой обработки собственное решение стоит проверить на реальных данных. Возможен и смешанный подход: типовые задачи выполняет локальная модель, сложные передаются более сильной внешней — если это допускают требования к данным.
И даже локальный запуск нужно рассматривать целиком: модель может находиться на вашем сервере, а поиск, журналы или другие инструменты — обращаться наружу.

